רגע! לפני שהולכים... 👋
אל תפספסו! מסלולי לימוד נפתחים בקרוב - מקומות מוגבלים
| מסלול Machine Learning | 06/10 |
| מסלול Cyber | 08/10 |
| מסלול Computer Vision | 08/10 |
| מסלול RT Embedded Linux | 09/11 |
✓ ייעוץ אישי ללא התחייבות | תשובה תוך 24 שעות
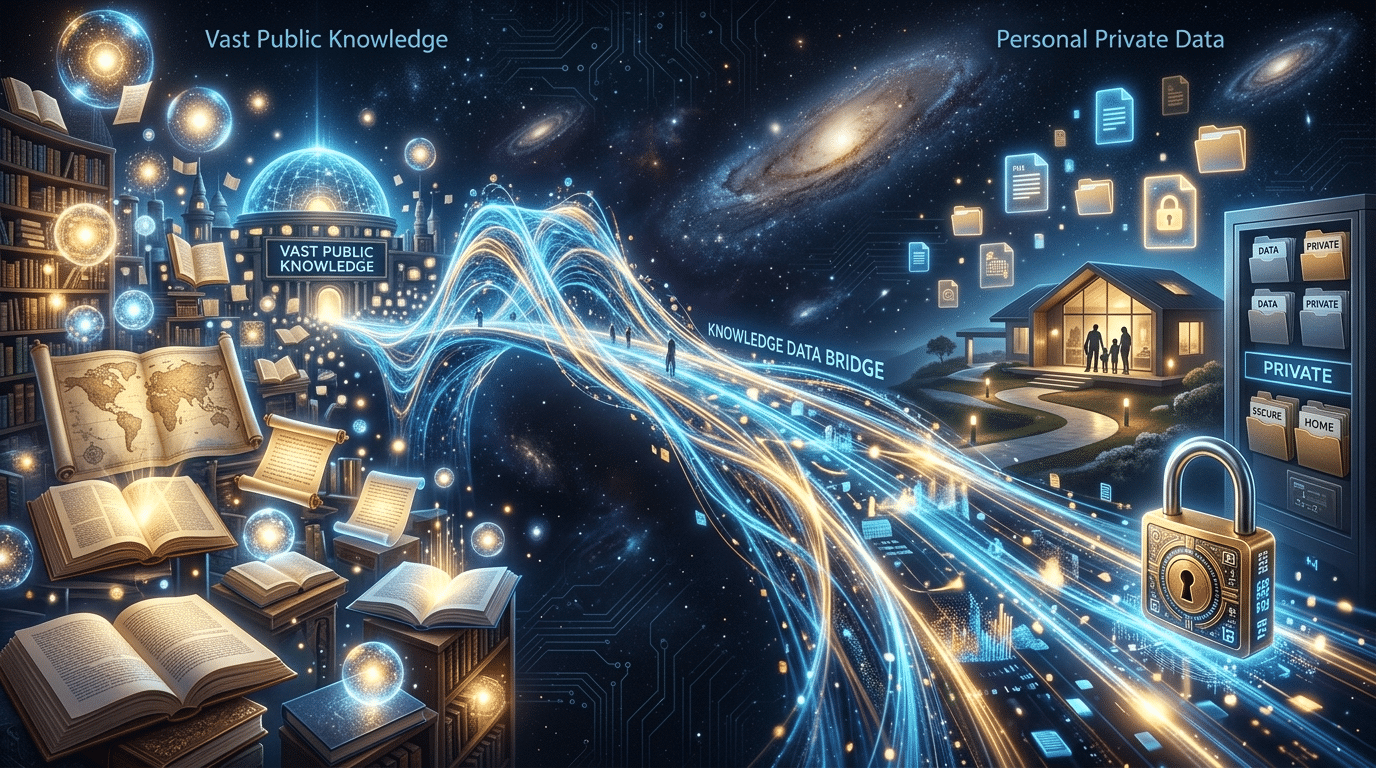
הגשר בין AI לנתונים הציבוריים והפרטיים שלך
עודכן לאחרונה: 16 ספטמבר, 2026
- למה בכלל צריך גשר בין AI לנתונים? מה לא עובד "מהקופסה"?
- איך בונים את הגשר? ארכיטקטורה מעשית שלב אחר שלב
- איזה כלים הכי מתאימים? השוואה מעשית
- איך נראה הקוד בפועל? דוגמה מעשית מקצה לקצה
- מתי כדאי לבחור RAG ומתי Fine-tuning?
- מה לגבי אבטחה ורגולציה? האם אפשר לעמוד בתקני פרטיות ישראליים?
- סיכום והמלצות
- שאלות נפוצות
- שכבת חיבור הנתונים (Data Integration Layer) היא הרכיב שמאפשר למודלי AI לגשת גם לנתונים ציבוריים וגם לנתונים פרטיים בצורה מאובטחת ויעילה.
- שימוש בטכניקות כמו RAG (Retrieval-Augmented Generation) מאפשר לשלב מידע ארגוני פרטי בתוך מודלי שפה בלי לחשוף אותו החוצה.
- ארכיטקטורת API Gateway עם שכבת הרשאות מבוססת תפקידים (RBAC) היא הדרך המעשית ביותר לשלוט מי רואה מה — גם כשה-AI עושה את העבודה.
- Pipeline אוטומטי לניקוי, סיווג ואינדוקס של נתונים הוא לא מותרות — הוא תנאי סף לכל פרויקט AI שנוגע בנתונים אמיתיים.
- הפרדה ברורה בין נתונים ציבוריים לפרטיים ברמת ה-Vector Store מונעת דליפות ומבטיחה עמידה ברגולציה.
הגשר שמחבר בין מודל AI לבין הנתונים שלך, הציבוריים והפרטיים כאחד, הוא בעצם שכבת אינטגרציה שכוללת צינור נתונים (Data Pipeline), מסד וקטורי (Vector Database), שכבת הרשאות, וטכניקת RAG שמאפשרת למודל לענות על שאלות תוך שימוש במידע ספציפי שלך, בלי לאמן אותו מחדש. זה לא קסם. זו הנדסה. ובמאמר הזה אני הולך להראות לך בדיוק איך בונים את הגשר הזה — צעד אחרי צעד, עם קוד אמיתי, כלים מעשיים, ותובנות מפרויקטים שעברנו בעצמנו. אם מישהו אומר לך שמספיק לקחת ChatGPT ולתת לו גישה לכל הקבצים — הוא מוכר לך חלומות. המציאות דורשת ארכיטקטורה חכמה, ואנחנו כאן כדי לפרק אותה לגורמים.
למה בכלל צריך גשר בין AI לנתונים? מה לא עובד "מהקופסה"?
מודלי שפה גדולים (LLMs) כמו GPT, Claude או Gemini אומנו על מידע ציבורי ענק. הם יודעים הרבה — אבל הם לא יודעים כלום על הנתונים הספציפיים שלך. לא על מסד הלקוחות, לא על תיעוד הפרויקט הפנימי, ולא על דוחות הרגולציה שצריך להגיש בסוף הרבעון.
כדי ש-AI יהיה שימושי באמת בתוך ארגון, הוא חייב לגשת לנתונים פרטיים, אבל בלי לחשוף אותם, בלי לדלוף, ובלי לשבור רגולציה. זה האתגר המרכזי. וכאן נכנס הגשר.
מה קורה כשמנסים בלי גשר?
בלי שכבת אינטגרציה מסודרת, צוותים נופלים לאחד משני מלכודות. המלכודת הראשונה: copy-paste של מידע רגיש לתוך ממשקי AI ציבוריים. לפי סקרים בתעשייה מהשנה האחרונה, למעלה מ-60% מעובדי מידע הודו שהעתיקו נתונים פנימיים ל-ChatGPT לפחות פעם אחת. המלכודת השנייה: ויתור על שימוש ב-AI לחלוטין בגלל חשש אבטחתי, מה שמשאיר את הארגון מאחור.
נקודת מפתח: הבעיה היא לא ש-AI לא מסוגל לעבוד עם נתונים פרטיים — הבעיה היא שרוב הארגונים לא בנו את השכבה שמאפשרת לו לעשות את זה בצורה בטוחה.
מהם הסוגים השונים של נתונים שה-AI צריך לגשת אליהם?
כשאנחנו מדברים על "נתונים ציבוריים" אנחנו מתכוונים למידע שזמין באינטרנט: דוקומנטציה טכנית, מאמרים אקדמיים, נתוני Open Data ממשלתיים, ויקיפדיה.
"נתונים פרטיים" כוללים כל מה שנמצא מאחורי חומת הארגון: מסדי נתונים פנימיים, מסמכי מדיניות, תכתובות, קוד מקור, נתוני לקוחות ועוד.
הגשר צריך לאפשר למודל לגשת לשני סוגי הנתונים, אבל בצורה שמבחינה ביניהם, שולטת בהרשאות, ומתעדת כל גישה. בלי הפרדה כזו, אתם בונים פצצה מתקתקת של דליפת מידע.
איך בונים את הגשר? ארכיטקטורה מעשית שלב אחר שלב
הארכיטקטורה שמוכיחה את עצמה שוב ושוב בפרויקטים אמיתיים מבוססת על חמישה רכיבים מרכזיים. אני לא מדבר על תאוריה, אני מדבר על מה שעובד בפרודקשן.
מהם חמשת הרכיבים הקריטיים של שכבת החיבור?
רכיב ראשון: Data Ingestion Pipeline — צינור שמושך נתונים ממקורות שונים (מסדי נתונים, APIs, קבצים, שירותי ענן), מנקה אותם, ומכין אותם לאינדוקס. כלים כמו Apache Airflow, Prefect או אפילו סקריפטים פשוטים ב-Python עם Celery מתאימים כאן.
רכיב שני: Embedding Engine — מנוע שממיר טקסט (או נתונים אחרים) לווקטורים מספריים. מודלים כמו text-embedding-ada-002 של OpenAI, sentence-transformers או מודלים מקומיים מ-HuggingFace עושים את העבודה. ההמרה הזו היא מה שמאפשר חיפוש סמנטי — לא רק התאמת מילות מפתח.
רכיב שלישי: Vector Store — מסד נתונים וקטורי שמאחסן את ה-Embeddings ומאפשר חיפוש מהיר לפי דמיון. Pinecone, Weaviate, Qdrant, Milvus ו-ChromaDB הם השחקנים המרכזיים. הבחירה תלויה בגודל הנתונים, בתקציב ובשאלה אם אתם רוצים שירות מנוהל או Self-hosted.
רכיב רביעי: RAG Orchestrator — השכבה שמקבלת שאילתת משתמש, מחפשת מסמכים רלוונטיים ב-Vector Store, ומעבירה אותם כהקשר למודל השפה. LangChain ו-LlamaIndex הם הפריימוורקים הנפוצים ביותר כאן, אם כי בשנה האחרונה עלו גם חלופות כמו Haystack של deepset.
רכיב חמישי: API Gateway + RBAC — שכבת בקרה שמוודאת שכל משתמש רואה רק את המידע שהוא מורשה לראות. כאן נכנסים כלים כמו Kong, AWS API Gateway, או פתרונות מבוססי OAuth2 + JWT.
טעות נפוצה: הרבה צוותים קופצים ישר ל-RAG בלי לבנות קודם את שכבת ה-Ingestion וה-RBAC. התוצאה - מודל שמחזיר תשובות לא רלוונטיות או חמור מזה, חושף מידע שלא אמור להיחשף.
איך מבטיחים הפרדה בין נתונים ציבוריים לפרטיים?
הגישה המומלצת היא ליצור שני אינדקסים נפרדים (או שני Namespaces בתוך אותו Vector Store). אינדקס ציבורי שנגיש לכל משתמש, ואינדקס פרטי שנגיש רק למי שמורשה. ברמת ה-RAG Orchestrator, ההגיון פשוט: לפני כל שאילתה, בדוק את ה-token של המשתמש, זהה את רמת ההרשאה, וחפש רק באינדקסים המתאימים.
בארגונים גדולים, יכולים להיות עשרות רמות הרשאה, פר-מחלקה, פר-פרויקט, או אפילו פר-מסמך. הפתרון הוא Metadata Filtering: כל מסמך שנכנס למערכת מקבל תגיות (labels) שמציינות מי רשאי לראות אותו. ברגע השאילתה, ה-Vector Store מסנן תוצאות לפי ה-metadata הזה.
איזה כלים הכי מתאימים? השוואה מעשית
בחירת הכלים תלויה במצב החברה, האם זה סטארטאפ קטן שצריך פתרון מהיר, או ארגון גדול שדורש שליטה מלאה? הנה השוואה מעשית:
| קריטריון | LangChain + Pinecone | LlamaIndex + Qdrant | Haystack + Weaviate | פתרון עצמאי (Custom) |
|---|---|---|---|---|
| קלות הקמה | גבוהה — הרבה דוגמאות קוד | בינונית — דוקומנטציה טובה אבל פחות דוגמאות | בינונית-גבוהה — קהילה חזקה | נמוכה — בונים הכל מאפס |
| שליטה ב-RBAC | בינונית — צריך להוסיף שכבה | גבוהה — Qdrant תומך ב-Payload Filtering | גבוהה — Weaviate תומך ב-Multi-tenancy | מלאה — אתם מגדירים הכל |
| עלות (לסטארטאפ קטן) | בינונית — Pinecone שירות בתשלום | נמוכה — Qdrant פתוח וחינמי ל-Self-host | נמוכה-בינונית | גבוהה בזמן, נמוכה בכסף |
| תמיכה במקורות מגוונים | מצוינת — מאות Connectors | טובה מאוד — PDF, DB, API | טובה — FileConverters מובנים | תלוי בכם |
| ביצועים בסקייל | תלוי ב-Pinecone tier | גבוהים — Qdrant מותאם לביצועים | גבוהים — Weaviate נבנה לסקייל | תלוי בארכיטקטורה שתבנו |
| מתאים במיוחד ל... | POC מהיר, צוותים קטנים | פרויקטים עם דגש אבטחה | ארגונים עם תשתיות קיימות | חברות עם צוות הנדסה חזק |
אין פתרון אחד נכון. יש פתרון שמתאים למה שאתם צריכים עכשיו ולאן אתם הולכים. הכלל שלי: תתחילו עם LangChain + ChromaDB לוולידציה מהירה, ותעברו לפתרון מנוהל כש-POC מוכיח ערך.
איך נראה הקוד בפועל? דוגמה מעשית מקצה לקצה
בואו נבנה גשר פשוט שמחבר נתונים ציבוריים (דוקומנטציה טכנית) ונתונים פרטיים (מסמכים ארגוניים) למודל שפה, עם הפרדת הרשאות. הנה הקוד המלא ב-Python:
# requirements: pip install langchain langchain-openai chromadb tiktoken

import os
from langchain_openai import OpenAIEmbeddings, ChatOpenAI
from langchain_community.vectorstores import Chroma
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain.chains import RetrievalQA
from langchain.schema import Document

# --- Step 1: Configure embeddings ---
os.environ["OPENAI_API_KEY"] = "your-api-key-here"
embeddings = OpenAIEmbeddings(model="text-embedding-ada-002")

# --- Step 2: Prepare documents with access-level metadata ---
public_docs = [
    Document(
        page_content="Python 3.12 introduces improved error messages and performance optimizations for comprehensions.",
        metadata={"source": "python-docs", "access_level": "public"}
    ),
    Document(
        page_content="FastAPI supports async endpoints natively and generates OpenAPI docs automatically.",
        metadata={"source": "fastapi-docs", "access_level": "public"}
    ),
]

private_docs = [
    Document(
        page_content="Q3 revenue reached 4.2M NIS. Key growth driver: enterprise API subscriptions.",
        metadata={"source": "internal-finance", "access_level": "private", "department": "finance"}
    ),
    Document(
        page_content="Production deployment uses 3 Kubernetes nodes with autoscaling between 2-8 replicas.",
        metadata={"source": "internal-devops", "access_level": "private", "department": "engineering"}
    ),
]

# --- Step 3: Split and index ---
splitter = RecursiveCharacterTextSplitter(chunk_size=500, chunk_overlap=50)
all_docs = splitter.split_documents(public_docs + private_docs)

vectorstore = Chroma.from_documents(
    documents=all_docs,
    embedding=embeddings,
    persist_directory="./chroma_db"
)

# --- Step 4: Query with access control ---
def query_with_access(question: str, user_access: str = "public"):
    """Query the RAG system with access-level filtering."""

    if user_access == "public":
        # Public users only see public docs
        filter_dict = {"access_level": "public"}
    elif user_access == "private":
        # Authenticated users see everything
        filter_dict = None  # No filter = all documents
    else:
        filter_dict = {"access_level": "public"}

    retriever = vectorstore.as_retriever(
        search_kwargs={
            "k": 3,
            "filter": filter_dict
        } if filter_dict else {"k": 3}
    )

    llm = ChatOpenAI(model="gpt-4", temperature=0)
    qa_chain = RetrievalQA.from_chain_type(
        llm=llm,
        chain_type="stuff",
        retriever=retriever,
        return_source_documents=True
    )

    result = qa_chain.invoke({"query": question})
    return result

# --- Usage Examples ---
# Public user - sees only public data
public_answer = query_with_access(
    "What are the new features in Python 3.12?",
    user_access="public"
)
print("Public:", public_answer["result"])

# Authenticated user - sees everything
private_answer = query_with_access(
    "What was Q3 revenue?",
    user_access="private"
)
print("Private:", private_answer["result"])
שימו לב ל-metadata שמוצמד לכל מסמך, שדה access_level שמאפשר סינון ברגע השאילתה. בפרודקשן, במקום הרדקוד של "public"/"private", אתם מושכים את רמת ההרשאה מ-JWT token שמגיע מ-API Gateway.
עכשיו בואו נראה את ה-Docker Compose שמרים את כל התשתית:
# docker-compose.yml - RAG infrastructure with access control

# Step 1: Create the compose file
cat > docker-compose.yml << 'EOF'
version: '3.8'
services:
  qdrant:
    image: qdrant/qdrant:latest
    ports:
      - "6333:6333"
      - "6334:6334"
    volumes:
      - qdrant_data:/qdrant/storage
    environment:
      - QDRANT__SERVICE__API_KEY=your-secret-key

  redis:
    image: redis:7-alpine
    ports:
      - "6379:6379"
    command: redis-server --requirepass your-redis-pass

  api-gateway:
    image: kong:3.4
    ports:
      - "8000:8000"
      - "8443:8443"
      - "8001:8001"
    environment:
      - KONG_DATABASE=off
      - KONG_DECLARATIVE_CONFIG=/kong/config.yml
    volumes:
      - ./kong-config.yml:/kong/config.yml

volumes:
  qdrant_data:
EOF

# Step 2: Start the infrastructure
docker-compose up -d

# Step 3: Verify all services are running
docker-compose ps

# Step 4: Test Qdrant health
curl -s http://localhost:6333/healthz | python3 -m json.tool
הסטאק הזה נותן לכם Vector Store (Qdrant), Cache Layer (Redis) ו-API Gateway (Kong) — שלושת הרכיבים הבסיסיים של שכבת החיבור. מכאן מוסיפים את ה-Python service שמריץ את ה-RAG logic.
מתי כדאי לבחור RAG ומתי Fine-tuning?
זו אחת השאלות הנפוצות ביותר, ורוב התשובות שתמצאו ברשת מבלבלות יותר ממה שהן עוזרות. אז בואו נפשט:
RAG (Retrieval-Augmented Generation) — המודל לא משתנה. אתם מזינים לו מידע רלוונטי בכל שאילתה, והוא עונה על בסיס מה שקיבל. היתרון: המידע תמיד עדכני, אין צורך באימון, והפרדת הרשאות פשוטה. החיסרון: ביצועים תלויים באיכות החיפוש, ויש מגבלה על כמות ההקשר שאפשר להעביר.
Fine-tuning — אתם מאמנים גרסה מותאמת של המודל על הנתונים שלכם. היתרון: המודל "מבין" את הדומיין שלכם ברמה עמוקה יותר, תשובות מהירות יותר. החיסרון: יקר, דורש תשתיות GPU, קשה לעדכן, וכמעט בלתי אפשרי ליישם הפרדת הרשאות — כי המידע "שקוע" בתוך המשקלות של המודל.
שורה תחתונה לפועלים: ב-90% מהמקרים, RAG הוא הפתרון הנכון כשאתם צריכים לחבר AI לנתונים ציבוריים ופרטיים. Fine-tuning שמור למקרים שבהם אתם צריכים שהמודל ידבר בסגנון מאוד ספציפי או יבצע משימה טכנית חוזרת.
לפי ניתוחים של חברות מובילות בתחום, ארגונים שהתחילו עם RAG הגיעו לפרודקשן פי 3 יותר מהר מאלה שקפצו ישר ל-Fine-tuning. הסיבה פשוטה: RAG דורש הנדסת נתונים, Fine-tuning דורש הנדסת ML. לרוב הצוותים יש יותר מהראשונה.
מה לגבי אבטחה ורגולציה? האם אפשר לעמוד בתקני פרטיות ישראליים?
שאלה קריטית, במיוחד בשוק הישראלי שבו חוק הגנת הפרטיות ותקנות אבטחת מידע (תקנות 5777) מחייבים התייחסות רצינית. התשובה: כן, אפשר, אבל צריך לתכנן את זה מראש, לא להוסיף בדיעבד.
אילו מנגנוני אבטחה חובה ליישם?
הצפנה בתנועה ובמנוחה (Encryption at rest and in transit): כל נתון שנכנס ל-Vector Store חייב להיות מוצפן. Qdrant ו-Weaviate תומכים ב-TLS ובהצפנת אחסון. אם אתם משתמשים ב-Pinecone — זה מובנה.
Data Residency: עבור ארגונים ישראליים, שימוש ב-Region ישראלי (אם קיים) או אירופי של ספק הענן מומלץ. AWS הרימו Region בישראל, ו-Azure הודיעו על תוכניות דומות. לחילופין, Self-hosted על שרתים מקומיים.
Audit Trail: כל שאילתה צריכה להיות מתועדת, מי שאל, מתי, אילו מסמכים הוחזרו, ומה הייתה התשובה. זה לא רק עניין רגולטורי, זה גם כלי לשיפור איכות התשובות לאורך זמן.
PII Detection and Masking: לפני שנתונים נכנסים ל-Pipeline, יש לסרוק אותם ולמסך מידע אישי מזהה (שמות, מספרי תעודת זהות, כתובות). ספריות כמו Presidio של Microsoft (שפותחה, אגב, על ידי צוות ישראלי) מאפשרות לעשות את זה אוטומטית, כולל תמיכה בעברית.
איך מתמודדים עם "הזייה" (Hallucination) כשנתונים פרטיים מעורבים?
הזייה של מודל שפה בהקשר ציבורי זה מטריד. הזייה בהקשר של נתונים פרטיים — כמו דוחות כספיים או מידע רפואי — זה מסוכן. הפתרון הוא שילוב של כמה טכניקות:
ראשית, Source Attribution — כל תשובה מלווה בציון המקור. אם המודל לא יכול להצביע על מסמך ספציפי שתומך בתשובה, הוא צריך להודות שאין לו מידע. שנית, Confidence Scoring — שימוש ב-Cosine Similarity ברמת ה-Retrieval כדי לקבוע אם המסמכים שנמצאו באמת רלוונטיים. אם הציון נמוך מסף מסוים (בדרך כלל 0.75-0.8), המערכת מחזירה "אין לי מספיק מידע לענות" במקום לנחש.
סיכום והמלצות
הגשר בין AI לנתונים שלך הוא לא מוצר שקונים מהמדף, הוא שכבת הנדסה שבונים בקפידה. הוא מורכב מצינור נתונים, מנוע Embedding, מסד וקטורי עם הפרדת הרשאות, ושכבת RAG שמתזמרת את הכל. מי שמבין איך לבנות את השכבה הזו, מחזיק במפתח לערך האמיתי שה-AI יכול לתת לארגון.
- התחילו עם POC קטן: קחו 50-100 מסמכים פנימיים, בנו Pipeline עם LangChain + ChromaDB, ותראו תוצאות תוך יום עבודה.
- הפרידו את האינדקסים מהיום הראשון: גם אם בהתחלה יש רק רמת הרשאה אחת — בנו את הארכיטקטורה להפרדה. להוסיף אחר כך זה פי 10 יותר קשה.
- השקיעו באיכות הנתונים, לא רק בכמות: 100 מסמכים נקיים ומסווגים שווים יותר מ-10,000 קבצים מבולגנים.
- יישמו Audit Trail מהרגע הראשון: זה יחסוך לכם כאב ראש רגולטורי וגם ייתן לכם Data לשיפור המערכת.
- אל תזניחו את ה-UX: הגשר הטוב בעולם לא שווה כלום אם המשתמשים לא סומכים על התשובות. Source Attribution והצגת מקורות — חובה.
עודכן: 2026-09-08
שאלות נפוצות
מה זה RAG ולמה צריך את זה?
RAG — Retrieval-Augmented Generation — היא טכניקה שמאפשרת למודל שפה לענות על שאלות תוך שימוש במידע חיצוני שמוזרם אליו בזמן אמת, בלי לאמן אותו מחדש. צריך את זה כי מודלי שפה לא מכירים את הנתונים הפרטיים של הארגון שלך. RAG נותן למודל "גישה" למידע הזה בצורה מבוקרת.
האם אפשר להשתמש ב-RAG עם מודלים מקומיים (לא בענן)?
בהחלט. מודלים כמו Llama 3, Mistral או Phi רצים מקומית על שרתים עם GPU. בשילוב עם Qdrant או ChromaDB שרצים Self-hosted, מקבלים מערכת RAG שלמה שלא שולחת שום נתון החוצה. זה הפתרון המועדף על ארגוני ביטחון ובריאות בישראל.
כמה זמן לוקח לבנות Pipeline כזה מאפס?
POC עובד — בין יום ליומיים עבור מפתח עם ניסיון בסיסי ב-Python. מערכת Production-ready עם RBAC מלא, Audit Trail, ותמיכה במקורות מגוונים, בין שבועיים לחודש, תלוי בגודל הצוות ובמורכבות הנתונים.
מה ההבדל בין Vector Database רגיל למסד נתונים רגיל?
מסד נתונים רגיל (כמו PostgreSQL) מחפש לפי התאמה מדויקת, שאילתות SQL עם תנאים. מסד וקטורי מחפש לפי דמיון סמנטי: "מצא לי את המסמכים שהכי דומים במשמעות לשאילתה הזו". זה מה שמאפשר למשתמש לשאול שאלה בעברית טבעית ולקבל תשובה ממסמכים שנכתבו בסגנון שונה לגמרי.
איך מתמודדים עם נתונים בעברית ב-RAG?
עברית מציבה אתגרים ייחודיים: כתיב חסר ניקוד, מורפולוגיה עשירה, וכיוון כתיבה RTL. המפתח הוא בחירת מודל Embedding שתומך בעברית ברמה טובה. מודלים מולטילינגואליים כמו multilingual-e5-large מראים תוצאות טובות. בנוסף, כדאי לנרמל את הטקסט לכתיב מלא לפני ה-Embedding.
מה העלות החודשית של תשתית RAG לסטארטאפ קטן?
אם משתמשים בכלים פתוחים (ChromaDB + מודל מקומי) על שרת אחד, עלות השרת בלבד, בערך 200-500 דולר בחודש. עם שירותים מנוהלים (Pinecone + OpenAI API) — מתחילים מ-100 דולר בחודש ועולים לפי כמות השאילתות. בפרויקט סטנדרטי עם כמה מאות שאילתות ביום, מדברים על 300-800 דולר בחודש.
האם צריך ידע ב-Machine Learning כדי לבנות שכבת RAG?
לא. זה אחד היתרונות הגדולים של הגישה הזו. RAG הוא בעיקר הנדסת תוכנה, צינורות נתונים, APIs, ותשתיות. אתם לא צריכים לאמן מודלים, אתם צריכים לדעת לבנות Pipeline טוב, לנהל מסדי נתונים, ולתכנן ארכיטקטורת הרשאות. מי שמגיע מרקע של Backend או DevOps יהיה בבית.
בניית הגשר בין AI לנתונים שלך היא לא משימה תאורטית, היא הנדסה מעשית, ומי שרוכש את הכלים האלה היום נמצא בדיוק במקום הנכון בזמן הנכון. אנחנו ב-RT-ED מאמינים שהידע הזה צריך להיות נגיש, לא מאחורי חומות של תואר שלישי. אם עניין אותך המאמר הזה ואתה רוצה להעמיק, יש לנו מדריכים נוספים שמפרקים את הנושאים האלה לרמת ביצוע, מ-Docker ו-Kubernetes ועד בניית מערכות AI מלאות. ה-מדריכים מחכים לך באתר rt-ed.co.il. הדלת פתוחה, תיכנסו.
מקורות לימוד מומלצים
קורסים: מסלול קורס AI Engineer המעניק הבנה מעמיקה בבנייה ואימון של מודלים למידת מכונה ולמידה עמוקה (Deep Learning), עבודה עם ארכיטקטורות Transformer, פיתוח אפליקציות מבוססות LLM (כמו RAG ו-Agents), ופריסת מודלים בסביבות ייצור (MLOps).
בלוגים / פורומים: Hugging Face Blog, Distill.pub, OpenAI Research, Towards Data Science (Medium), Reddit (r/MachineLearning, r/LocalLLaMA).
ספרים: Hands-On Machine Learning with Scikit-Learn, Keras, and TensorFlow (של Aurélien Géron), Designing Machine Learning Systems (של Chip Huyen).
- למה בכלל צריך גשר בין AI לנתונים? מה לא עובד "מהקופסה"?
- איך בונים את הגשר? ארכיטקטורה מעשית שלב אחר שלב
- איזה כלים הכי מתאימים? השוואה מעשית
- איך נראה הקוד בפועל? דוגמה מעשית מקצה לקצה
- מתי כדאי לבחור RAG ומתי Fine-tuning?
- מה לגבי אבטחה ורגולציה? האם אפשר לעמוד בתקני פרטיות ישראליים?
- סיכום והמלצות
- שאלות נפוצות