רגע! לפני שהולכים... 👋
אל תפספסו! מסלולי לימוד נפתחים בקרוב - מקומות מוגבלים
| מסלול Machine Learning | 06/10 |
| מסלול Cyber | 08/10 |
| מסלול Computer Vision | 08/10 |
| מסלול RT Embedded Linux | 09/11 |
✓ ייעוץ אישי ללא התחייבות | תשובה תוך 24 שעות
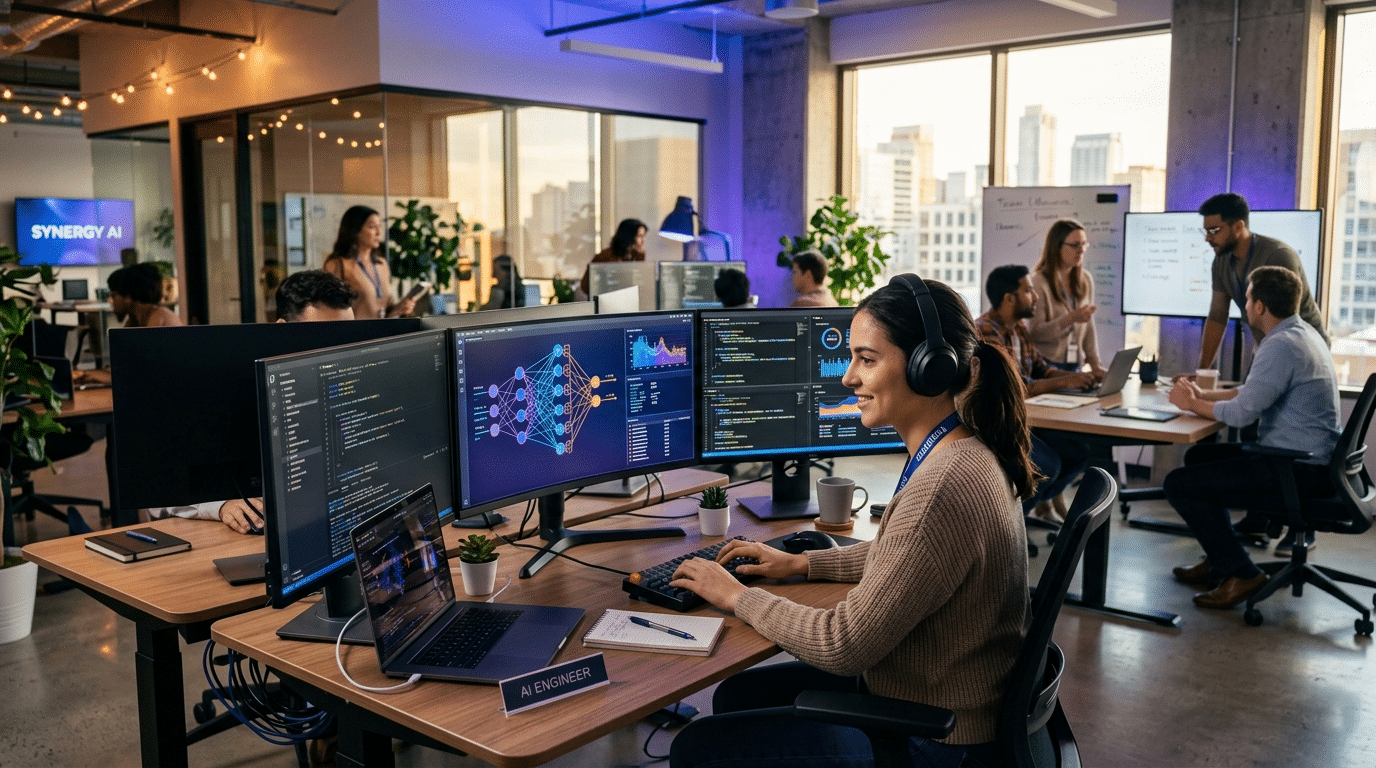
שילוב AI Engineer בצוותי פיתוח: יום בחיי מהנדס AI
עודכן לאחרונה: 16 ספטמבר, 2026
- מהנדס AI אינו ישות נפרדת, הוא חלק אינטגרלי מצוות הפיתוח, ויום העבודה שלו משלב כתיבת קוד, אופטימיזציה של מודלים, ועבודה צמודה עם מפתחי Backend ו-DevOps.
- שילוב מוצלח דורש הגדרת ממשקים ברורים: מהנדס AI אחראי על ה-pipeline מקצה לקצה, מעיבוד נתונים, דרך אימון, ועד deployment בפרודקשן.
- הכלים המרכזיים שמגשרים בין צוות AI לצוות פיתוח כוללים MLflow לניהול מודלים, Docker ליצירת סביבות אחידות, ו-FastAPI לחשיפת מודלים כ-API.
- ארגונים שמשלבים AI Engineer מהיום הראשון בצוות ולא כ"יועץ חיצוני" — רואים ירידה של עד 40% בזמן ה-time-to-production של מודלים.
- המפתח להצלחה: מהנדס AI חייב לדבר את השפה של צוות הפיתוח — Git, CI/CD, code review — ולא רק את השפה של Jupyter Notebook.
מהנדס AI שמשתלב בצוות פיתוח קיים לא יושב במגדל שן ומאמן מודלים, הוא כותב קוד פרודקשן, משתתף ב-standups, עובר code reviews, ומרים שירותים לייב, בדיוק כמו כל מפתח אחר בצוות. ההבדל? הוא מביא לשולחן ידע עמוק בלמידת מכונה, עיבוד נתונים, ואופטימיזציה של מודלים, וזה בדיוק מה שהופך אותו מ"נחמד שיש" ל"חייבים שיהיה". אם אתם מנהלים צוות פיתוח ושוקלים לשלב מהנדס AI, או שאתם עצמכם רוצים להיכנס לתפקיד הזה, המדריך הזה מפרק את זה לרמת יום-יום, עם כלים, קוד, ותהליכים קונקרטיים.
מה בעצם עושה מהנדס AI ביום-יום בתוך צוות פיתוח?
בואו נהיה כנים: רוב האנשים חושבים שמהנדס AI יושב כל היום ומשחק עם Jupyter Notebooks, מריץ ניסויים ומצייר גרפים. במציאות הישראלית, בחברות שמשלבות AI ברצינות, מ-Mobileye ועד סטארטאפים בשלבים מוקדמים, היום נראה אחרת לגמרי.
איך נראה לוח הזמנים של מהנדס AI טיפוסי?
08:30–09:00 — Daily standup עם הצוות. מהנדס AI מדווח בדיוק כמו כל מפתח: מה עשיתי אתמול, מה אני עושה היום, מה חוסם אותי. ההבדל? לפעמים החסימה היא "חסר לי dataset נקי" ולא "חסר לי API endpoint".
09:00–11:00 — עבודה על data pipeline. רוב הזמן של מהנדס AI לא הולך על בניית מודלים, הוא הולך על הכנת נתונים. ניקוי, תיוג, תיקוף, ובניית צינורות אוטומטיים שמזרימים את הנתונים הנכונים למודל.
11:00–13:00 — אימון ואופטימיזציה של מודלים. כאן נכנסת האקספרטיזה הייחודית. בחירת ארכיטקטורה, כוונון היפר-פרמטרים, ניסויים עם גישות שונות. כל ניסוי מתועד ב-MLflow או כלי דומה.
14:00–16:00 — אינטגרציה עם קוד הפרודקשן. כתיבת קוד Python או C++ שמעביר את המודל מסביבת ניסויים ל-API שירות שהצוות יכול לצרוך. כאן מהנדס AI עובד יד-ביד עם מפתחי Backend.
16:00–17:30 — Code review, דוקומנטציה, ותכנון. בדיוק כמו כל מפתח. מהנדס AI טוב כותב קוד שאחרים יכולים לקרוא, לתחזק ולהרחיב.
נקודת מפתח: מהנדס AI שלא יודע לכתוב קוד פרודקשן נקי, לעבוד עם Git ולעבור code review — הוא חוקר, לא מהנדס. ההבדל הזה קריטי.
מה ההבדל בין מהנדס AI למהנדס תוכנה רגיל?
ההבדל לא בכמות הקוד, אלא באופי הבעיות. מהנדס תוכנה קלאסי פותר בעיות דטרמיניסטיות — אם הקלט הוא X, הפלט חייב להיות Y. מהנדס AI עובד בעולם סטוכסטי, המודל נותן תשובה עם הסתברות, ומשימתו לדאוג שההסתברות הזו תהיה גבוהה מספיק כדי לייצר ערך עסקי.
בפועל, מהנדס AI צריך את כל הכישורים של מהנדס תוכנה — ובנוסף: הבנה של מתמטיקה וסטטיסטיקה, ניסיון באימון מודלים, והיכולת לתרגם בעיה עסקית לבעיית Machine Learning.
איך משלבים מהנדס AI בצוות פיתוח קיים בלי לפוצץ את הכימיה?
זה האתגר הגדול באמת. לא מספיק לגייס מישהו עם ידע ב-PyTorch ולזרוק אותו לתוך צוות Backend. צריך תהליך מחושב. לפי סקרים בתעשייה בשנים האחרונות, כ-60% מפרויקטי AI בארגונים נכשלים לא בגלל בעיות טכנולוגיות — אלא בגלל חיכוכים ארגוניים ואי-התאמה בין צוותים.
מה הצעדים המעשיים לשילוב מוצלח?
צעד 1: הגדרת ממשקים ברורים. עוד לפני שמהנדס AI כותב שורת קוד אחת, הצוות צריך להגדיר: מי אחראי על מה? איזה חלק מהקוד שייך ל-AI ואיזה חלק למפתחי Backend? איפה עובר הגבול? הכלל הפשוט: מהנדס AI אחראי מ-data ingestion ועד model serving. מפתח Backend אחראי מ-API gateway ומעלה.
צעד 2: אימוץ כלים משותפים. מהנדס AI שעובד ב-Jupyter Notebook ומפתחי Backend שעובדים ב-VS Code עם Git — זה מתכון לאסון. הפתרון: מהנדס AI חייב לעבוד באותו stack כמו כל הצוות. Git, CI/CD, Docker, monitoring — הכל אותו דבר.
צעד 3: שפה משותפת. מהנדסי AI מדברים על accuracy, precision, recall ו-F1 score. מפתחי Backend מדברים על latency, throughput ו-uptime. הצעד הקריטי הוא לבנות "מילון" משותף — לתרגם מטריקות AI למטריקות עסקיות ותפעוליות שכולם מבינים.
צעד 4: שילוב הדרגתי. אל תתנו למהנדס AI פרויקט ענק ביום הראשון. תתחילו עם משימה קטנה שמייצרת ערך מהיר — למשל, מודל פשוט לקלסיפיקציה שמחליף לוגיקה מבוססת כללים. הצלחה מהירה בונה אמון.
צעד 5: Code review הדדי. מהנדס AI צריך לעבור code review ממפתחי Backend — ולהיפך. זה לא רק על איכות קוד. זה על בניית הבנה הדדית ושפה משותפת.
טעות נפוצה: ארגונים רבים מקימים "צוות AI נפרד" שיושב ביחידה משלו, מנותק מצוותי הפיתוח. התוצאה? מודלים מבריקים שאף פעם לא מגיעים לפרודקשן. שילוב embedded בתוך צוותי המוצר מוכיח את עצמו כגישה היעילה יותר.
אילו כלים מאפשרים גישור בין מהנדסי AI לצוותי פיתוח?
הבחירה בכלים הנכונים יכולה להפוך שילוב כואב לתהליך חלק. הנה השוואה בין הכלים המרכזיים שמשמשים צוותים מעורבים בתעשייה הישראלית:
| כלי | תפקיד עיקרי | מתאים למי? | עקומת למידה | אינטגרציה עם CI/CD |
|---|---|---|---|---|
| MLflow | ניהול ניסויים, מעקב אחרי מודלים, model registry | צוותים שרוצים לתעד כל ניסוי ולנהל גרסאות מודלים | בינונית | מצוין — תומך ב-REST API, אינטגרציה עם GitHub Actions |
| DVC (Data Version Control) | ניהול גרסאות של datasets וקבצי מודלים גדולים | צוותים שעובדים עם Git ורוצים לנהל נתונים כמו קוד | נמוכה | מצוין — משתלב ישירות עם Git |
| BentoML | אריזת מודלים כ-API services מוכנים לפרודקשן | מהנדסי AI שרוצים להעביר מודלים מהר ל-deployment | נמוכה-בינונית | טוב — תומך ב-Docker ו-Kubernetes |
| Weights & Biases | מעקב אחרי ניסויים, ויזואליזציה, שיתוף תוצאות | צוותים גדולים שצריכים שקיפות מלאה על ניסויי AI | נמוכה | טוב — API webhooks ואינטגרציה עם כלי CI |
איך בונים pipeline של AI-to-Production מא' ועד ת'?
אחד הדברים שמפריד בין מהנדס AI חובבן למהנדס AI מקצועי הוא היכולת לקחת מודל מ-notebook ולהעביר אותו לפרודקשן — עם monitoring, גרסאות, ויכולת rollback. זה לא קסם. זה MLOps — והוא הליבה של העבודה.
מה כולל pipeline של MLOps בפועל?
ה-pipeline המינימלי שכל צוות צריך כולל חמישה שלבים: איסוף ועיבוד נתונים, אימון מודל, בדיקות אוטומטיות (unit tests + integration tests), אריזה ב-Docker, ו-deployment ל-production עם monitoring. בואו נראה את זה בקוד אמיתי.
הנה דוגמה של מבנה פרויקט AI שמתנהג כמו כל microservice אחר בצוות:
# מבנה ספריות של פרויקט AI-as-a-service
mkdir -p ai-service/{src,tests,models,data,configs}
cd ai-service

# יצירת virtual environment
python3 -m venv venv
source venv/bin/activate

# התקנת תלויות
pip install fastapi uvicorn scikit-learn mlflow pydantic

# מבנה הפרויקט:
# ai-service/
# ├── src/
# │   ├── train.py         # סקריפט אימון
# │   ├── predict.py        # לוגיקת inference
# │   └── api.py            # FastAPI endpoint
# ├── tests/
# │   ├── test_predict.py   # unit tests למודל
# │   └── test_api.py       # integration tests ל-API
# ├── models/               # מודלים מאומנים (tracked by DVC)
# ├── configs/
# │   └── model_config.yaml # הגדרות היפר-פרמטרים
# ├── Dockerfile
# ├── requirements.txt
# └── .github/workflows/
#     └── ci-cd.yaml        # GitHub Actions pipeline
ועכשיו ה-API עצמו — הקובץ שמחבר את המודל למערכת הפרודקשן:
# src/api.py — FastAPI service for ML model inference
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel
import pickle
import numpy as np
import os

app = FastAPI(title="AI Prediction Service", version="1.0.0")

# Load model at startup
MODEL_PATH = os.getenv("MODEL_PATH", "models/classifier_v1.pkl")

def load_model():
    try:
        with open(MODEL_PATH, "rb") as f:
            return pickle.load(f)
    except FileNotFoundError:
        raise RuntimeError(f"Model not found at {MODEL_PATH}")

model = load_model()

class PredictionRequest(BaseModel):
    features: list[float]

class PredictionResponse(BaseModel):
    prediction: int
    confidence: float

@app.get("/health")
def health_check():
    return {"status": "healthy", "model_version": MODEL_PATH}

@app.post("/predict", response_model=PredictionResponse)
def predict(request: PredictionRequest):
    try:
        features = np.array(request.features).reshape(1, -1)
        prediction = model.predict(features)[0]
        confidence = float(max(model.predict_proba(features)[0]))
        return PredictionResponse(
            prediction=int(prediction),
            confidence=confidence
        )
    except Exception as e:
        raise HTTPException(status_code=500, detail=str(e))

# Run: uvicorn src.api:app --host 0.0.0.0 --port 8000
וה-Dockerfile שמאפשר למפתחי DevOps בצוות לקחת את השירות ולהריץ אותו בכל סביבה:
FROM python:3.11-slim

WORKDIR /app

COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt

COPY src/ ./src/
COPY models/ ./models/
COPY configs/ ./configs/

ENV MODEL_PATH=models/classifier_v1.pkl

EXPOSE 8000

CMD ["uvicorn", "src.api:app", "--host", "0.0.0.0", "--port", "8000"]
שימו לב: הקוד הזה לא שונה מהותית ממה שכל מפתח Backend כותב. זה בדיוק הנקודה, מהנדס AI שמשתלב בצוות פיתוח חייב לכתוב קוד שנראה ומתנהג כמו קוד פרודקשן.
איך CI/CD של מודל AI שונה מ-CI/CD רגיל?
ב-CI/CD רגיל, הבדיקות מוודאות שהקוד עובד. ב-CI/CD של מודל AI, הבדיקות מוודאות גם שהמודל עובד — כלומר, שהביצועים שלו (accuracy, latency, memory usage) עומדים בסף המינימלי. הנה דוגמה של GitHub Actions workflow שעושה בדיוק את זה:
# .github/workflows/ci-cd.yaml
name: AI Service CI/CD

on:
  push:
    branches: [main, develop]
  pull_request:
    branches: [main]

jobs:
  test:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4

      - name: Set up Python
        uses: actions/setup-python@v5
        with:
          python-version: '3.11'

      - name: Install dependencies
        run: |
          pip install -r requirements.txt
          pip install pytest

      - name: Run unit tests
        run: pytest tests/test_predict.py -v

      - name: Run model quality checks
        run: |
          python -c "
          import pickle, numpy as np
          with open('models/classifier_v1.pkl', 'rb') as f:
              model = pickle.load(f)
          # Smoke test: verify model outputs valid predictions
          test_input = np.random.rand(1, 10)
          pred = model.predict(test_input)
          proba = model.predict_proba(test_input)
          assert pred.shape == (1,), 'Prediction shape mismatch'
          assert 0 <= max(proba[0]) <= 1, 'Invalid probability'
          print('Model quality checks passed')
          "

      - name: Run API integration tests
        run: |
          uvicorn src.api:app --host 0.0.0.0 --port 8000 &
          sleep 3
          curl -f http://localhost:8000/health
          pytest tests/test_api.py -v

  deploy:
    needs: test
    if: github.ref == 'refs/heads/main'
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4

      - name: Build and push Docker image
        run: |
          docker build -t ai-service:${{ github.sha }} .
          echo "Ready for deployment to production"
שורה תחתונה לפועלים: אם מהנדס AI בצוות שלכם לא יכול להסביר את ה-CI/CD pipeline שלו ב-standup — יש בעיה. כל שורת קוד שמהנדס AI כותב חייבת לעבור את אותו תהליך איכות כמו כל קוד אחר בארגון.
מה נדרש כדי להפוך למהנדס AI שצוותי פיתוח רוצים לעבוד איתו?
זה לא רק עניין של ידע טכני. לפי נתונים מסקרי מגייסים בתעשייה הישראלית בשנים האחרונות, שלושת הקריטריונים המובילים בגיוס מהנדסי AI הם: ניסיון בכתיבת קוד פרודקשן (לא רק notebooks), היכרות עם תהליכי DevOps/MLOps, ויכולת תקשורת עם צוותים טכניים ועסקיים.
אילו כישורים טכניים חייבים להיות?
Python ברמת פרודקשן. לא מספיק לדעת לכתוב סקריפטים — צריך להכיר OOP, design patterns, typing, ו-testing. מהנדס AI שכותב פונקציות של 200 שורות בלי טיפוסים ובלי בדיקות — לא ישרוד code review.
Deep Learning frameworks. PyTorch הוא הסטנדרט בתעשייה כיום, אבל TensorFlow עדיין רלוונטי מאוד — במיוחד ב-Edge AI ובסביבות production. מהנדס AI טוב שולט לפחות באחד ומכיר את השני.
Docker ו-Kubernetes. מינימום: לדעת לבנות Dockerfile, להריץ containers, ולהבין בסיסי של Kubernetes — pods, services, deployments. אם המודל שלכם לא רץ ב-container — הוא לא פרודקשן.
Git ו-CI/CD. branching strategies, pull requests, merge conflicts. מהנדס AI שלא יודע לעבוד עם Git הוא כמו נהג שלא יודע להתניע.
SQL וידע בסיסי ב-data engineering. לפחות ברמה של שליפת נתונים, הבנה של schemas, ויכולת לכתוב queries יעילים. רוב הנתונים שמהנדס AI עובד איתם יושבים ב-databases.
מה בנוגע לכישורים הרכים?
כאן נגיד את מה שהמעטים מעזים להגיד: מהנדס AI שלא יודע להסביר למנהל מוצר למה המודל שלו לא עובד ב-100% accuracy — ישרף תקציבים ואמון. היכולת לתקשר אי-ודאות, לתרגם מטריקות טכניות לשפה עסקית, ולהגיד "אני לא יודע עדיין" בלי לאבד ביטחון, זה גולד.
בתעשייה הישראלית, שמאופיינת בצוותים קטנים וישירים, מהנדס AI ש"יורד לעם" ומסביר בשפה פשוטה מה עושה המודל, למה הוא לפעמים טועה, ומה צריך כדי לשפר אותו, הוא הסוג שכולם רוצים בצוות.
סיכום והמלצות
מהנדס AI שמשתלב בצוות פיתוח קיים חייב להיות קודם כל מהנדס — ורק אחר כך AI. היום בחיי מהנדס AI כולל הרבה יותר Git, Docker ו-standups מאשר ניסויים ב-Jupyter. ההצלחה בשילוב נמדדת לא בדיוק של המודל, אלא ביכולת להעביר אותו לפרודקשן ולייצר ערך עסקי — יחד עם כל הצוות.
- התחילו עם ממשקים ברורים: הגדירו מי אחראי על מה לפני שכותבים שורת קוד אחת.
- אמצו כלים משותפים: MLflow, DVC ו-Docker הם הגשר בין עולם ה-AI לעולם הפיתוח.
- דרשו קוד פרודקשן: כל מודל AI חייב לעבור אותו תהליך CI/CD כמו כל שירות אחר.
- תתחילו קטן: פרויקט ראשון קטן ומוצלח שווה יותר משלושה פרויקטים גדולים שנתקעו.
- השקיעו בתקשורת: מהנדס AI שיודע לדבר עם מפתחים, מנהלי מוצר ו-QA — שווה זהב.
עודכן: 2026-09-14
שאלות נפוצות
מה ההבדל בין Data Scientist לבין AI Engineer?
Data Scientist מתמקד בניתוח נתונים, בניית מודלים סטטיסטיים ומציאת תובנות. AI Engineer לוקח את המודלים האלה ובונה סביבם מערכת פרודקשן — API, monitoring, CI/CD, ואינטגרציה עם מוצרים קיימים. בפועל, בחברות ישראליות רבות התפקידים מתמזגים, אבל ההתמקצעות ב-engineering side הולכת וגדלה.
האם צריך תואר במדעי המחשב כדי להיות מהנדס AI?
תואר עוזר — בעיקר בגלל הבסיס במתמטיקה ובסטטיסטיקה. אבל לא חסרים מהנדסי AI מצוינים שהגיעו מתוכניות הכשרה מעשיות, bootcamps איכותיים, ולמידה עצמאית. מה שחשוב יותר מתואר: פורטפוליו של פרויקטים אמיתיים, ניסיון בקוד פרודקשן, ויכולת ללמוד מהר.
כמה זמן לוקח למהנדס AI חדש להשתלב בצוות קיים?
בהנחה שהמהנדס מגיע עם רקע טכני מתאים, תהליך onboarding טיפוסי לוקח בין 4 ל-8 שבועות. השבועיים הראשונים מוקדשים להבנת הקוד הקיים, הכלים והתהליכים. מהשבוע השלישי מתחילים לתרום קוד. שילוב מלא — כולל אחריות על pipeline שלם — לוקח בדרך כלל כשלושה חודשים.
אילו שפות תכנות מהנדס AI צריך לדעת?
Python היא חובה — אין דרך לעקוף את זה. מעבר לזה, שימושי מאוד: SQL לעבודה עם נתונים, Bash לסקריפטים ואוטומציה, ו-C++ למקרים שדורשים ביצועים גבוהים (כמו Edge AI או inference בזמן אמת). TypeScript שימושית אם עובדים קרוב לצד ה-Frontend.
מה השכר של מהנדס AI בישראל?
שכר של מהנדס AI בישראל נע בין 25,000 ל-45,000 ש"ח ברוטו למשרה מלאה בשנים הראשונות, ועולה משמעותית עם ניסיון. מהנדסי AI בכירים עם 5+ שנות ניסיון מגיעים לטווח של 45,000-65,000 ש"ח ומעלה. השכר מושפע מאוד מגודל החברה, מהתעשייה ומרמת האחריות.
מה ההבדל בין MLOps ל-DevOps?
DevOps עוסק באוטומציה של תהליכי פיתוח ותפעול של תוכנה — CI/CD, infrastructure as code, monitoring. MLOps מוסיף על גבי DevOps את הצרכים הייחודיים של מודלי ML: ניהול גרסאות של נתונים ומודלים, מעקב אחרי ניסויים, זיהוי data drift, ו-retraining אוטומטי. בפועל, מהנדס AI טוב חייב להכיר את שניהם.
איך מתחילים ללמוד AI Engineering בלי ניסיון קודם?
הדרך הכי יעילה: להתחיל מ-Python חזק ומוצק, לעבור ללימוד יסודות של Machine Learning (מושגים כמו supervised vs unsupervised, overfitting, cross-validation), ואז להתרגל לבנות פרויקטים מקצה לקצה — לא רק מודלים, אלא שירותים שלמים עם API, בדיקות ו-Docker. הכשרה מעשית שמדמה סביבת עבודה אמיתית שווה הרבה יותר מקורס תיאורטי.
אנחנו רואים כל יום מהנדסים ומהנדסות שנכנסים לעולם ה-AI מרקעים שונים — Embedded, Backend, DevOps, ואפילו QA. מה שמשותף לכולם? סקרנות, נכונות לזיעה, ורצון ללמוד כלים חדשים בלי לפחד מטעויות. אם זה נשמע כמוכם — אתם במקום הנכון. באתר rt-ed.co.il תמצאו מדריכים נוספים, סילבוסים מפורטים, ותוכניות הכשרה מעשיות שבנויות בדיוק סביב המיומנויות שדיברנו עליהן פה — קוד פרודקשן, MLOps, ועבודת צוות אמיתית. הדלת פתוחה.
מקורות לימוד מומלצים
קורסים: מסלול קורס AI Engineer המעניק הבנה מעמיקה בבנייה ואימון של מודלים למידת מכונה ולמידה עמוקה (Deep Learning), עבודה עם ארכיטקטורות Transformer, פיתוח אפליקציות מבוססות LLM (כמו RAG ו-Agents), ופריסת מודלים בסביבות ייצור (MLOps).
בלוגים / פורומים: Hugging Face Blog, Distill.pub, OpenAI Research, Towards Data Science (Medium), Reddit (r/MachineLearning, r/LocalLLaMA).
ספרים: Hands-On Machine Learning with Scikit-Learn, Keras, and TensorFlow (של Aurélien Géron), Designing Machine Learning Systems (של Chip Huyen).