רגע! לפני שהולכים... 👋
אל תפספסו! מסלולי לימוד נפתחים בקרוב - מקומות מוגבלים
| מסלול Machine Learning | 06/10 |
| מסלול Cyber | 08/10 |
| מסלול Computer Vision | 08/10 |
| מסלול RT Embedded Linux | 09/11 |
✓ ייעוץ אישי ללא התחייבות | תשובה תוך 24 שעות
איך לבנות אפליקציית RAG ארגונית מאפס עם LangChain
עודכן לאחרונה: 16 ספטמבר, 2026
- אפליקציית RAG (Retrieval-Augmented Generation) ארגונית משלבת מנוע חיפוש וקטורי עם מודל שפה גדול (LLM) כדי לייצר תשובות מבוססות על המידע הפנימי של הארגון — לא על "הזיות".
- הארכיטקטורה המינימלית כוללת שלושה רכיבים: צינור עיבוד מסמכים (Ingestion Pipeline), מסד נתונים וקטורי (Vector Store), ושרשרת שאילתות שמחברת בין ה-Retriever ל-LLM.
- ניתן לבנות MVP עובד תוך שבוע עבודה עם LangChain, מסד וקטורי כמו Qdrant או Weaviate, ומודל Embedding מקומי או API של OpenAI.
- ההבדל בין RAG צעצוע ל-RAG ארגוני נמצא ב-Chunking Strategy, מנגנוני הרשאות, מוניטורינג של תשובות, ויכולת סקיילינג לעשרות אלפי מסמכים.
- עלות הכניסה נמוכה, אפשר להתחיל עם קוד פתוח בלבד, בלי לשלם שקל על רישיונות.
כדי לבנות אפליקציית RAG ארגונית מאפס, צריך לחבר שלושה חלקים: צינור שמכניס מסמכים, שובר אותם לחתיכות (Chunks), ממיר אותם לווקטורים ושומר במסד וקטורי; שכבת חיפוש שיודעת לאחזר את הקטעים הרלוונטיים ביותר לשאלה; ושרשרת שמזינה את ההקשר המאוחזר למודל שפה גדול ומחזירה תשובה מבוססת מקורות. זה לא קסם, זו הנדסה. והמדריך הזה ייקח אותך שלב אחרי שלב, עם קוד אמיתי שאפשר להריץ היום, כדי שתקום מהכיסא עם אפליקציית RAG עובדת.
מה זה RAG ולמה ארגונים צריכים את זה?
RAG — ראשי תיבות של Retrieval-Augmented Generation — היא ארכיטקטורה שפותחה במקור על ידי חוקרים ב-Meta AI. הרעיון פשוט ועמוק בו זמנית: במקום לסמוך על הידע שהמודל "שינן" בזמן האימון, מזריקים לו מידע רלוונטי בזמן אמת מתוך מאגר מסמכים פנימי.
לפי סקרים בתעשייה מהשנה האחרונה, למעלה מ-60% מהארגונים שמשלבים LLM בתהליכי עבודה סובלים מבעיית "הזיות", המודל ממציא עובדות בביטחון מפחיד. RAG פותר את זה כי המודל מקבל הנחיה ברורה: "ענה רק על בסיס הקטעים הבאים", ובתשובה מצוינים המקורות.
מתי כדאי לבחור RAG ומתי Fine-Tuning?
זו שאלה שעולה בכל ארגון שנכנס לעולם ה-LLM. התשובה הקצרה: RAG מתאים כשהמידע משתנה לעיתים קרובות, כש-latency סביר של כמה שניות מקובל, וכשאתם רוצים שקיפות (citation) של מקורות. Fine-Tuning מתאים כשצריך לשנות את הטון, הסגנון או ההתנהגות הבסיסית של המודל.
ברוב המקרים הארגוניים — מסמכי נהלים, מאגרי ידע, תיעוד טכני, חוזים — RAG הוא הפתרון הנכון. הוא זול יותר, מהיר יותר ליישום, ולא דורש GPU farm לאימון.
נקודת מפתח: RAG הוא לא תחליף ל-Fine-Tuning — הם משלימים. ב-80% מהתרחישים הארגוניים, RAG לבדו מספיק. ב-20% הנותרים, שילוב של שניהם נותן את התוצאה הטובה ביותר.
מה הארכיטקטורה של אפליקציית RAG ארגונית?
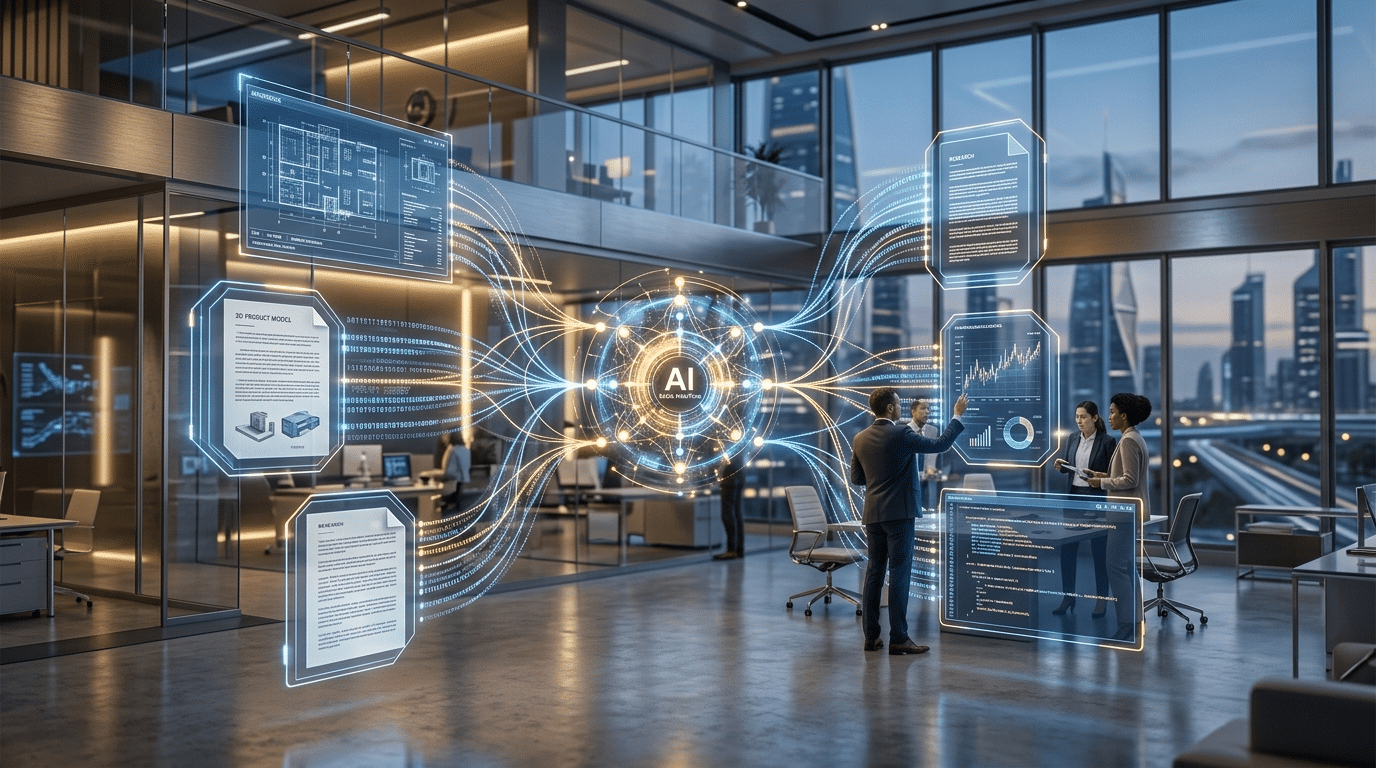
לפני שנצלול לקוד, בואו נבין את התמונה הגדולה. אפליקציית RAG ארגונית מורכבת משלושה צינורות (Pipelines) שעובדים יחד:
צינור ראשון — Ingestion: לוקח מסמכים גולמיים (PDF, Confluence, Google Docs, Slack threads, קוד), מנקה אותם, שובר לחתיכות (Chunks), ממיר כל חתיכה לווקטור באמצעות מודל Embedding, ושומר במסד וקטורי.
צינור שני — Retrieval: מקבל שאלה מהמשתמש, ממיר אותה לווקטור, מחפש את ה-K חתיכות הכי דומות סמנטית, ומחזיר אותן כהקשר.
צינור שלישי — Generation: בונה prompt שמכיל את ההקשר המאוחזר + השאלה המקורית, שולח ל-LLM, ומחזיר תשובה עם ציון מקורות.
איך בוחרים מסד נתונים וקטורי?
המסד הווקטורי הוא הלב של מערכת RAG. הוא שומר את כל הווקטורים ומבצע חיפוש שכנים קרובים (Approximate Nearest Neighbor — ANN) בזמן אמת. כיום יש שורה של אפשרויות בשלות, וכל אחת עם מאפיינים שונים.
| מסד וקטורי | רישיון | מנוהל בענן | סינון מטאדטה | מתאים לארגון | הערות |
|---|---|---|---|---|---|
| Qdrant | Apache 2.0 | כן (Qdrant Cloud) | מצוין — payload filtering | כן | ביצועים גבוהים, Rust-based, תמיכה מקומית ב-multi-tenancy |
| Weaviate | BSD-3 | כן | GraphQL-based filtering | כן | תמיכה מובנית ב-hybrid search (וקטורי + מילות מפתח) |
| Pinecone | SaaS בלבד | כן (managed only) | טוב | כן | הכי קל להתחלה, אין אפשרות self-hosted |
| ChromaDB | Apache 2.0 | בטא | בסיסי | ל-MVP בלבד | מצוין לפרוטוטייפ, פחות בשל לייצור |
| pgvector (PostgreSQL) | PostgreSQL | כן (כל ספק PostgreSQL) | מלא — SQL | כן | אם כבר יש PostgreSQL בארגון — שווה לשקול, פשטות מבצעית |
ל-MVP, ChromaDB מספיק ומריץ הכול בזיכרון. לייצור ארגוני, Qdrant או Weaviate הם הבחירה הנפוצה ביותר בקהילה, עם Pinecone כאלטרנטיבה מנוהלת לארגונים שמעדיפים SaaS.
איזה מודל Embedding כדאי לבחור?
מודל ה-Embedding הוא מה שממיר טקסט לווקטור מספרי. הבחירה כאן קריטית — אם ה-Embeddings לא איכותיים, גם ה-Retrieval לא יהיה איכותי, ואז ה-LLM יקבל הקשר לא רלוונטי.
לטקסט באנגלית, מודלים כמו text-embedding-3-large של OpenAI או bge-large-en-v1.5 של BAAI נותנים תוצאות מצוינות. עבור עברית — וזה נושא רגיש בארגונים ישראליים, מודלים רב-לשוניים כמו multilingual-e5-large של Intfloat או text-embedding-3-large של OpenAI מציגים ביצועים סבירים, אבל כדאי מאוד לעשות בדיקת איכות (evaluation) על המסמכים שלכם לפני שנועלים בחירה.
טעות נפוצה: הרבה צוותים בוחרים מודל Embedding לפי benchmark כללי ולא לפי ביצועים על הדאטה שלהם. תמיד כדאי להריץ evaluation קטן — 50-100 שאלות עם תשובות ידועות — ולמדוד Hit Rate ו-MRR לפני שמתחייבים.
איך בונים את הצינור בפועל, שלב אחרי שלב?
שלב 1: הכנת סביבת העבודה
נתחיל מהתקנת הכלים. אנחנו הולכים לעבוד עם Python, LangChain כמסגרת אורקסטרציה, Qdrant כמסד וקטורי, ומודל של OpenAI — אבל כל רכיב ניתן להחלפה.
# יצירת סביבה וירטואלית
python -m venv rag-env
source rag-env/bin/activate

# התקנת חבילות
pip install langchain langchain-openai langchain-community
pip install qdrant-client
pip install unstructured[pdf]    # לעיבוד PDF
pip install tiktoken              # לספירת טוקנים
pip install python-dotenv

# הרצת Qdrant מקומי עם Docker
docker run -d --name qdrant
  -p 6333:6333
  -v $(pwd)/qdrant_storage:/qdrant/storage
  qdrant/qdrant:latest
תוך דקה יש לכם מסד וקטורי רץ מקומית. לא צריך שרתים, לא צריך הרשמה. בדקו שהוא עובד:
curl http://localhost:6333/collections
# אמור להחזיר: {"result":{"collections":[]},"status":"ok","time":...}
שלב 2: בניית צינור ה-Ingestion
זה החלק שהכי מזלזלים בו, והוא הכי משפיע על איכות התשובות. צינור ה-Ingestion לוקח מסמכים גולמיים, מפרק, מנקה, חותך לחתיכות, ושומר כווקטורים.
import os
from dotenv import load_dotenv
from langchain_community.document_loaders import DirectoryLoader, UnstructuredPDFLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_openai import OpenAIEmbeddings
from langchain_community.vectorstores import Qdrant

load_dotenv()

# --- שלב 1: טעינת מסמכים ---
loader = DirectoryLoader(
    "./documents",
    glob="**/*.pdf",
    loader_cls=UnstructuredPDFLoader,
    show_progress=True
)
documents = loader.load()
print(f"נטענו {len(documents)} מסמכים")

# --- שלב 2: חיתוך לחתיכות (Chunking) ---
text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=1000,          # גודל חתיכה בתווים
    chunk_overlap=200,        # חפיפה בין חתיכות
    separators=["nn", "n", ".", " "],
    length_function=len,
)
chunks = text_splitter.split_documents(documents)
print(f"נוצרו {len(chunks)} חתיכות")

# --- שלב 3: הוספת מטאדטה ---
for i, chunk in enumerate(chunks):
    chunk.metadata["chunk_id"] = i
    chunk.metadata["source_file"] = chunk.metadata.get("source", "unknown")

# --- שלב 4: יצירת Embeddings ושמירה ב-Qdrant ---
embeddings = OpenAIEmbeddings(
    model="text-embedding-3-large",
    openai_api_key=os.getenv("OPENAI_API_KEY")
)

vectorstore = Qdrant.from_documents(
    documents=chunks,
    embedding=embeddings,
    url="http://localhost:6333",
    collection_name="enterprise_docs",
    force_recreate=True  # True רק בפעם הראשונה
)

print(f"הווקטורים נשמרו בהצלחה ב-Qdrant — collection: enterprise_docs")
כמה נקודות קריטיות בקוד הזה:
chunk_size: 1000 תווים זה נקודת התחלה טובה. חתיכות קטנות מדי מאבדות הקשר, גדולות מדי מכניסות רעש. הרבה ארגונים מגיעים בסוף ל-500-1500 תווים אחרי ניסוי וטעייה.
chunk_overlap: 200 תווים חפיפה מבטיחים שמשפט שנחתך באמצע עדיין מופיע בחתיכה אחת שלמה. בלי חפיפה, אתם מאבדים מידע בגבולות.
מטאדטה: חובה! בלי מטאדטה לא תוכלו לציין מקור בתשובה, ולא תוכלו לסנן לפי הרשאות.
שלב 3: בניית שרשרת ה-RAG
עכשיו מגיע החלק המרגש — חיבור כל הרכיבים לשרשרת שמקבלת שאלה ומחזירה תשובה מבוססת מקורות.
from langchain_openai import ChatOpenAI
from langchain.prompts import ChatPromptTemplate
from langchain.schema.runnable import RunnablePassthrough
from langchain.schema.output_parser import StrOutputParser

# --- Retriever ---
retriever = vectorstore.as_retriever(
    search_type="mmr",         # Maximum Marginal Relevance — גיוון תוצאות
    search_kwargs={
        "k": 5,               # מספר חתיכות לאחזר
        "fetch_k": 20,        # מספר מועמדים לפני סינון MMR
        "lambda_mult": 0.7    # איזון בין רלוונטיות לגיוון
    }
)

# --- Prompt Template ---
template = """אתה עוזר ארגוני מקצועי. ענה על השאלה אך ורק על בסיס ההקשר המסופק.
אם אין מספיק מידע בהקשר — אמור בכנות שאין לך מספיק מידע.
ציין את המקורות בסוף התשובה.

הקשר:
{context}

שאלה: {question}

תשובה:"""

prompt = ChatPromptTemplate.from_template(template)

# --- LLM ---
llm = ChatOpenAI(
    model="gpt-4o",
    temperature=0.1,          # טמפרטורה נמוכה = תשובות עקביות
    openai_api_key=os.getenv("OPENAI_API_KEY")
)

# --- Helper: פורמט מסמכים ---
def format_docs(docs):
    formatted = []
    for i, doc in enumerate(docs):
        source = doc.metadata.get("source_file", "לא ידוע")
        formatted.append(f"[מקור {i+1}: {source}]n{doc.page_content}")
    return "nn---nn".join(formatted)

# --- שרשרת RAG ---
rag_chain = (
    {"context": retriever | format_docs, "question": RunnablePassthrough()}
    | prompt
    | llm
    | StrOutputParser()
)

# --- הרצה ---
question = "מה מדיניות החופשות בחברה?"
answer = rag_chain.invoke(question)
print(answer)
שימו לב לשימוש ב-search_type="mmr" — זה Maximum Marginal Relevance, אלגוריתם שמאזן בין רלוונטיות לגיוון. בלי זה, יכול לקרות שחמש החתיכות שחוזרות הן כמעט זהות, וה-LLM מקבל נקודת מבט אחת בלבד.
שלב 4: מה הופך RAG ל"ארגוני"?
עד כאן בנינו RAG שעובד. אבל הפער בין "עובד על הלפטופ" ל"רץ בייצור בארגון" הוא עצום. הנה הרכיבים שצריך להוסיף:
הרשאות ו-Access Control: בארגון, לא כל עובד רשאי לראות כל מסמך. צריך לשמור מטאדטה של הרשאות (קבוצות, מחלקות, רמות סיווג) ולסנן תוצאות בזמן אמת. ב-Qdrant זה נעשה דרך payload filtering — מוסיפים שדה allowed_groups לכל חתיכה ומסננים בשאילתה.
מוניטורינג ו-Evaluation: צריך לעקוב אחרי איכות התשובות לאורך זמן. כלים כמו LangSmith, Ragas או Phoenix של Arize מאפשרים למדוד מדדים כמו Faithfulness (האם התשובה נאמנה להקשר), Relevancy (האם ההקשר רלוונטי לשאלה), ו-Answer Correctness.
צינור עדכון רציף: מסמכים ארגוניים משתנים. צריך צינור שרץ יומית או שבועית, מזהה מסמכים חדשים או שהשתנו, ומעדכן את הווקטורים בהתאם. בלי זה — המערכת עונה על בסיס מידע ישן.
Guardrails: מנגנונים שמונעים מהמערכת לייצר תוכן לא רצוי, לחשוף מידע רגיש, או לענות על שאלות שחורגות מתחום הידע שלה.
שורה תחתונה לפועלים: אל תשקיעו שלושה חודשים בבניית MVP מושלם. תעלו גרסה ראשונה תוך שבוע, תתנו למשתמשים אמיתיים לשאול שאלות, ותשפרו לפי הפידבק. ה-Chunking Strategy שלכם תשתנה לפחות שלוש פעמים לפני שתמצאו את הנקודה המתוקה.
איך מתמודדים עם האתגרים הנפוצים?
מה עושים כשהמסמכים בעברית?
עברית מציבה אתגרים ייחודיים ב-RAG. ראשית, Tokenization — מודלים רבים מבוססים אנגלית שוברים טקסט עברי לטוקנים ארוכים ויקרים, מה שאומר שכל שאילתה עולה יותר ושחלון ההקשר מתמלא מהר יותר.
שנית, Embedding Quality — מודלים רב-לשוניים עובדים, אבל לא באותה רמה כמו על אנגלית. לפי בדיקות שנעשו בקהילת המפתחים הישראלית, text-embedding-3-large של OpenAI נותן תוצאות סבירות על עברית, אבל שווה לבדוק גם מודלים כמו e5-mistral-7b-instruct שמראים שיפור על שפות שמאל-לימין.
טיפ מעשי: אם יש לכם מסמכים בעברית, שווה לנסות Hybrid Search — שילוב של חיפוש וקטורי עם חיפוש מילות מפתח קלאסי (BM25). Weaviate תומך בזה מובנית, וב-LangChain אפשר לממש את זה עם EnsembleRetriever.
איך מונעים הזיות ומוודאים אמינות?
הזיות הן האויב הגדול של כל מערכת RAG ארגונית. מנהל שמקבל תשובה שגויה ממערכת שנראית סמכותית, זו בעיה רצינית. הנה ארבע שכבות הגנה:
1. Prompt Engineering קפדני: ההנחיה המפורשת "ענה רק על בסיס ההקשר" מפחיתה הזיות באופן דרמטי. הוסיפו גם: "אם אינך בטוח, אמור 'אין לי מספיק מידע'".
2. טמפרטורה נמוכה: temperature=0.0 עד 0.2 נותנת תשובות דטרמיניסטיות ועקביות יותר.
3. Citation Verification: כתבו לוגיקה שמוודאת שכל טענה בתשובה באמת מופיעה באחד הקטעים שאוחזרו. אם לא — מסמנים את התשובה כחשודה.
4. Human-in-the-Loop: למערכות קריטיות, הוסיפו כפתור "דווח על תשובה שגויה" ושמרו כל דיווח לשיפור מתמשך.
סיכום והמלצות
בניית אפליקציית RAG ארגונית היא לא מדע טילים — זו הנדסת תוכנה מוצקה עם כלים בשלים שזמינים בקוד פתוח. המפתח להצלחה הוא לא הטכנולוגיה, אלא הגישה: להתחיל קטן, למדוד, ולשפר לפי פידבק אמיתי ממשתמשים אמיתיים.
- התחילו עם MVP תוך שבוע: LangChain + Qdrant בדוקר + OpenAI API — זה כל מה שצריך לגרסה ראשונה.
- השקיעו ב-Chunking: 80% מאיכות התשובות נקבעת באיכות החיתוך. נסו גדלים שונים, חפיפות שונות, ומדדו.
- הוסיפו מטאדטה מהיום הראשון: מקור, תאריך, הרשאות — אי אפשר להוסיף בדיעבד בלי לעבד את הכול מחדש.
- מדדו את האיכות: בנו מערכת evaluation עם 50-100 שאלות ותשובות מוכרות, והריצו אותה אחרי כל שינוי.
- תכננו לסקייל: מה שעובד על 100 מסמכים לא בהכרח עובד על 100,000. חשבו מראש על אינדקסציה אינקרמנטלית ועל multi-tenancy.
עודכן: 2026-09-09
שאלות נפוצות
כמה זמן לוקח לבנות אפליקציית RAG ארגונית מאפס?
MVP עובד — שבוע עבודה בממוצע. גרסה ארגונית מלאה עם הרשאות, מוניטורינג, ו-UI — בין חודש לשלושה חודשים, תלוי בהיקף המסמכים ובדרישות האבטחה. ההמלצה שלנו: תשיקו MVP תוך שבוע ותשפרו בהדרגה, לא לחכות שלושה חודשים למשהו "מושלם".
האם חייבים OpenAI או שאפשר לעבוד עם מודלים מקומיים?
בהחלט אפשר לעבוד לגמרי בקוד פתוח. למודל שפה: Llama 3 של Meta, Mistral, או Qwen רצים מקומית עם Ollama או vLLM. למודל Embedding: מודלים כמו bge-large-en-v1.5 או multilingual-e5-large רצים חינם על CPU. ב-Qdrant ו-LangChain — הכול קוד פתוח. ארגונים עם דרישות רגולטוריות (ביטחון, פיננסים, בריאות) מעדיפים לעיתים קרובות פתרון מקומי לגמרי — וזה אפשרי.
מה ההבדל בין RAG לבין חיפוש רגיל במסמכים?
חיפוש רגיל (כמו Elasticsearch) מוצא מסמכים רלוונטיים ומציג אותם. RAG עושה צעד נוסף: הוא לוקח את המסמכים הרלוונטיים, מעביר אותם ל-LLM, וה-LLM מסנתז מהם תשובה ישירה בשפה טבעית עם ציון מקורות. במקום "הנה 10 מסמכים — תחפש בעצמך", המשתמש מקבל "לפי נוהל X, מדיניות החופשות היא Y".
כמה עולה להריץ מערכת RAG ארגונית?
עלויות תלויות מאוד בנפח. לארגון עם 10,000 מסמכים ו-500 שאילתות ביום: עלות ה-Embedding חד-פעמית היא כ-5-15 דולר (OpenAI), עלות Qdrant Cloud מתחילה בכ-25 דולר לחודש, ועלות ה-LLM לשאילתות — כ-50-150 דולר לחודש עם GPT-4o-mini, או אפס אם משתמשים במודל מקומי. סך הכול: עשרות עד מאות בודדות של דולרים לחודש. פחות מעלות שעה אחת של יועץ.
האם RAG מתאים למסמכים עם טבלאות, תמונות ותרשימים?
טקסט רגיל — כן, עובד מעולה. טבלאות — צריך Loader מיוחד (כמו UnstructuredPDFLoader עם מצב hi_res) שמשמר מבנה טבלאי. תמונות ותרשימים — זה תחום שנקרא Multimodal RAG, והוא עדיין בהתבגרות. הפתרונות הנפוצים כוללים שימוש ב-LLM עם יכולות Vision (כמו GPT-4o) לתיאור תמונות, או מודלים ייעודיים כמו ColPali שעושים retrieval ישירות על תמונות מסמכים.
מה קורה כשמסמכים מתעדכנים — צריך לבנות הכול מחדש?
לא. הגישה הנכונה היא אינדקסציה אינקרמנטלית: לשמור hash של כל מסמך, ובכל הרצה של צינור ה-Ingestion להשוות מול ה-hash השמור. מסמכים חדשים — מוסיפים. מסמכים שהשתנו, מוחקים את הווקטורים הישנים ומכניסים חדשים. מסמכים שנמחקו, מוחקים מהמסד. Qdrant תומך במחיקה לפי metadata filter, מה שמקל מאוד על התהליך.
האם LangChain הוא הכלי הנכון או שיש אלטרנטיבות?
LangChain הוא הכלי הפופולרי ביותר ויש לו אקוסיסטם עצום, אבל יש לו גם חסרונות, הוא יכול להיות מופשט מדי (over-abstracted) ומסורבל עבור מקרים פשוטים. אלטרנטיבות שווות בדיקה: LlamaIndex — ממוקד יותר ב-RAG ויש לו יכולות Ingestion מתקדמות; Haystack של deepset — ארכיטקטורה מודולרית מאוד; או פשוט לכתוב ישירות מול ה-SDK של Qdrant/Weaviate + OpenAI בלי שום framework — לארכיטקטורות פשוטות זו לפעמים הגישה הכי נקייה.
בנייה של מערכת RAG ארגונית היא אחד הפרויקטים הכי מעשיים ומבוקשים בשוק כרגע, כי זה בדיוק המקום שבו AI גנרטיבי פוגש בעיות אמיתיות של עסקים אמיתיים. לא צריך תואר שני ב-NLP כדי להתחיל. צריך סקרנות, נכונות ללכלך את הידיים בקוד, וסבלנות לחזור על ה-Chunking Strategy שלכם עד שהתוצאות מדויקות. אם הדבר הזה מדבר אליכם ואתם רוצים להמשיך ולהעמיק, יש מדריכים נוספים ותכנים מעשיים באתר rt-ed.co.il. הדלת פתוחה.
מקורות לימוד מומלצים
קורסים: מסלול קורס AI Engineer המעניק הבנה מעמיקה בבנייה ואימון של מודלים למידת מכונה ולמידה עמוקה (Deep Learning), עבודה עם ארכיטקטורות Transformer, פיתוח אפליקציות מבוססות LLM (כמו RAG ו-Agents), ופריסת מודלים בסביבות ייצור (MLOps).
בלוגים / פורומים: Hugging Face Blog, Distill.pub, OpenAI Research, Towards Data Science (Medium), Reddit (r/MachineLearning, r/LocalLLaMA).
ספרים: Hands-On Machine Learning with Scikit-Learn, Keras, and TensorFlow (של Aurélien Géron), Designing Machine Learning Systems (של Chip Huyen).